Vous avez déjà vu un modèle de langage inventer des faits avec une assurance désarmante ? C'est ce qu'on appelle une hallucination, et c'est le talon d'Achille des grands modèles de langage (LLM) en entreprise. La solution ne réside pas dans un entraînement plus long, mais dans l'ancrage du modèle à la réalité via des bases de connaissances structurées. En connectant votre LLM à des sources vérifiables, vous transformez un générateur de texte créatif en un assistant fiable et précis.
Ce qu'il faut retenir
- Réduction des erreurs : L'ancrage réduit les hallucinations de 30 à 50 % selon les benchmarks industriels.
- Technique dominante : Le Retrieval-Augmented Generation (RAG) est la méthode standard pour injecter des connaissances externes.
- Coût d'entrée : Une implémentation RAG basique coûte entre 15 000 et 50 000 dollars, principalement due à la préparation des données.
- Adoption massive : D'ici 2026, on estime que 80 % des déploiements LLM en entreprise intégreront une forme d'ancrage.
Pourquoi les LLM seuls ne suffisent plus
Les modèles comme GPT-4 ou Claude ont été entraînés sur des vastes corpus de textes jusqu'à une date donnée. Ils sont brillants pour synthétiser des idées, mais ils ignorent tout de ce qui s'est passé hier matin si cela n'était pas dans leurs poids neuronaux. Pire, ils comblent les trous de leur mémoire par des probabilités linguistiques, pas par des faits. Si vous demandez à un LLM non ancré les détails d'une politique interne récente ou le prix exact d'un produit mis à jour cette semaine, il risque de deviner.
L'ancrage (grounding) est le processus qui consiste à lier les réponses du modèle à des sources de vérité externes. Selon Microsoft, c'est crucial pour garantir la pertinence dans des cas d'usage spécifiques où l'information n'existe pas dans les données d'entraînement générales. Sans ancrage, vous ne pouvez pas faire confiance aux sorties pour des tâches critiques comme le support client technique ou la conformité financière.
Le cœur du système : le Retrieval-Augmented Generation (RAG)
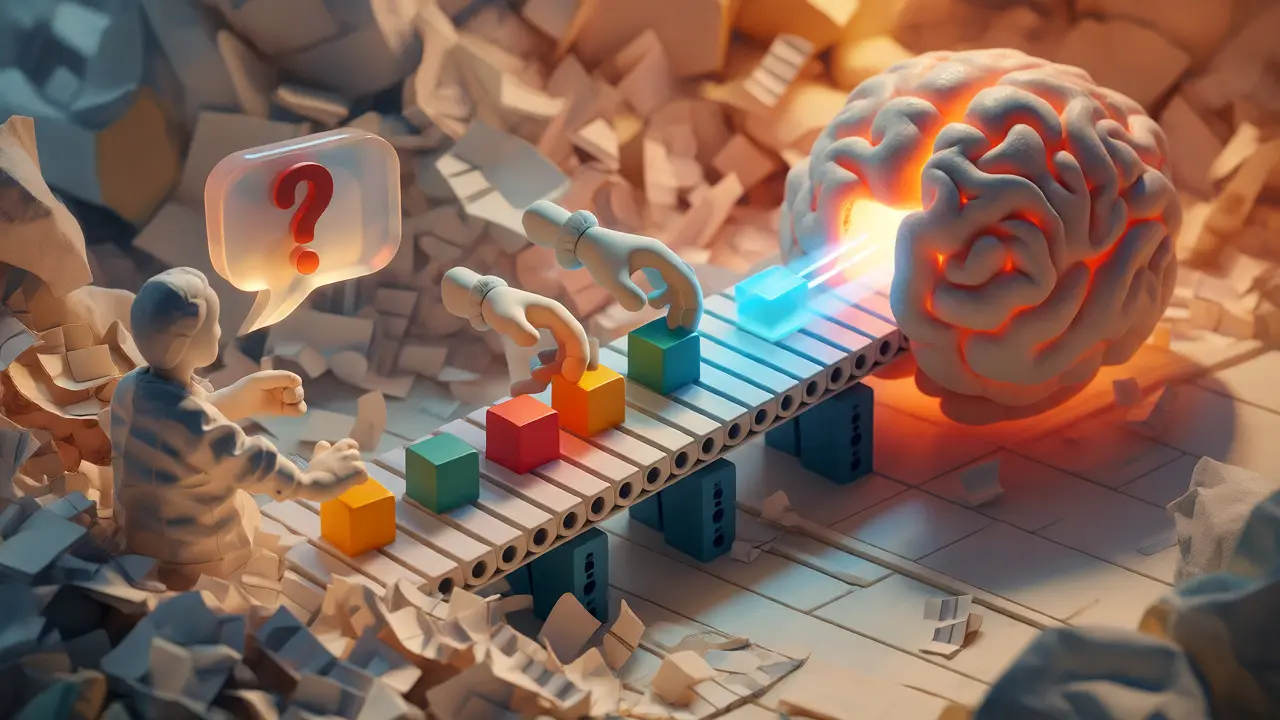
La technique la plus répandue pour réaliser cet ancrage est le Retrieval-Augmented Generation (une architecture qui combine la récupération d'informations et la génération de texte). Le principe est simple : avant de générer une réponse, le système va chercher les documents pertinents dans une base de données externe, puis donne ces extraits au LLM comme contexte.
Voici comment ça se passe concrètement en quatre étapes :
- Requête utilisateur : L'utilisateur pose une question.
- Recherche sémantique : Le système interroge une base vectorielle (comme Pinecone ou Weaviate) pour trouver les passages les plus proches sémantiquement.
- Injection de contexte : Les documents trouvés sont insérés dans le prompt envoyé au LLM.
- Génération : Le modèle rédige sa réponse en s'appuyant exclusivement sur ces faits fournis.
Cette approche améliore la précision factuelle de 22 à 37 % par rapport au fine-tuning classique, car elle permet au modèle de citer ses sources plutôt que de s'appuyer sur sa mémoire paramétrique floue.
Le rôle crucial des bases de connaissances structurées
Tout le monde parle de RAG, mais beaucoup échouent parce qu'ils négligent la qualité de la source. Injecter des PDF bruts ou des pages web mal formatées donne des résultats médiocres. C'est là que les bases de connaissances structurées prennent tout leur sens.
Une base structurée organise l'information autour d'entités claires (clients, produits, transactions) avec des identifiants uniques et des relations définies. Par exemple, au lieu de chercher "la politique de remboursement", le système peut interroger directement l'entité "Politique_Client_A" et récupérer les champs spécifiques "délai" et "conditions". Cette granularité permet une recherche beaucoup plus précise.
Les technologies comme Wikidata ou DBpedia montrent la voie en offrant des graphes de connaissances où chaque fait est lié à d'autres. Pour une entreprise, créer des "Entity-Based Data Products" signifie transformer des données éparses en objets propres et interrogables. Cela réduit considérablement le bruit lors de la phase de récupération (retrieval).
| Critère | LLM Standard (Non Ancré) | RAG + Base Structurée |
|---|---|---|
| Précision Factuelle | Moyenne (risque d'hallucination élevé) | Élevée (réponses vérifiables) |
| Frais de Mise à Jour | Très élevés (ré-entraînement complet) | Faibles (mise à jour de la base de données) |
| Latence | Faible (< 200ms) | Modérée (nécessite une étape de recherche) |
| Transparence | Boîte noire (difficile de tracer l'origine) | Élevée (citations des sources possibles) |
| Coût Initial | Variable selon l'API | 15k - 50k $ (infrastructure + ingénierie) |
Défis techniques et pièges courants
Si l'ancrage semble magique, il apporte son lot de complexités. Le premier défi est la fenêtre de contexte. Même avec les modèles modernes, vous ne pouvez pas injecter toute votre base de données. Vous devez envoyer seulement les fragments les plus pertinents, souvent limités à quelques milliers de tokens. Si votre algorithme de recherche sélectionne les mauvais passages, la réponse sera mauvaise, même si le LLM est parfait.
Un autre problème majeur est la maintenance. Une base de connaissances obsolète est pire qu'une absence de base. Si votre document "Tarifs 2025" reste indexé alors que nous sommes en 2026, le LLM citera des prix faux avec autorité. Il faut mettre en place des pipelines automatisés qui rafraîchissent le contenu toutes les 24 à 72 heures pour les données sensibles.
Enfin, la latence compte. Ajouter une étape de recherche vectorielle ajoute du temps. Pour des applications interactives comme le chatbot support, il faut viser moins de 500 ms pour la phase de récupération. Des solutions hybrides combinant recherche par mots-clés (rapide) et recherche sémantique (précise) peuvent améliorer les résultats de 30 % tout en maîtrisant la vitesse.
Impact réel sur la confiance utilisateur
Est-ce que ça marche vraiment ? Les retours terrain sont éloquents. Sur des plateformes comme G2 Crowd, les solutions ancrées obtiennent une note moyenne de 4,6/5 pour la précision, contre 3,2/5 pour les modèles purs. 78 % des utilisateurs citent la réduction du temps de vérification des faits comme bénéfice principal.
Dans le secteur financier, un data scientist rapportait sur Reddit une réduction de 40 % des références réglementaires incorrectes après avoir branché son LLM sur les dépôts SEC structurés. Dans la santé, un prestataire a vu une baisse de 25 % des erreurs d'information médicale grâce à un ancrage sur des protocoles cliniques officiels. Ces chiffres ne sont pas théoriques ; ils traduisent une réalité opérationnelle où la confiance se construit par la traçabilité.
Perspectives d'avenir : vers l'auto-ancrage
Nous ne faisons qu'effleurer la surface. Actuellement, l'ancrage demande encore beaucoup d'ingénierie manuelle pour structurer les données. Mais la tendance va vers des systèmes plus autonomes. Des recherches récentes, notamment de Stanford, introduisent le concept de "Entity-Guided RAG", qui modélise explicitement les relations entre entités pour améliorer la précision de 35 %.
À horizon 2027, certains analystes prédisent l'émergence de modèles "auto-ancrés" capables de vérifier eux-mêmes leurs affirmations auprès de sources de confiance pendant la génération, sans intervention humaine constante. Pour l'instant, investir dans une infrastructure de données propre et structurée reste le meilleur moyen de préparer votre entreprise à cette évolution.
Questions fréquentes
Qu'est-ce que la génération ancrée (grounded generation) ?
C'est une technique qui contraint un grand modèle de langage (LLM) à fonder ses réponses sur des informations externes vérifiables, plutôt que sur sa seule mémoire interne. Cela vise à réduire les hallucinations et à augmenter la fiabilité des réponses dans des contextes professionnels.
Quelle est la différence entre RAG et Fine-Tuning ?
Le Fine-Tuning ajuste les poids internes du modèle avec de nouvelles données, ce qui est coûteux et lent à mettre à jour. Le RAG (Retrieval-Augmented Generation) laisse le modèle intact mais lui fournit dynamiquement des informations pertinentes issues d'une base de données externe au moment de la requête, permettant des mises à jour instantanées et peu coûteuses.
Pourquoi utiliser une base de connaissances structurée plutôt que des documents bruts ?
Les bases structurées organisent l'information en entités et relations claires (ex: Client -> Achat -> Produit). Cela permet au système de recherche de retrouver des faits précis avec moins de bruit que la simple analyse de texte brut, améliorant ainsi la pertinence des informations envoyées au LLM.
Combien coûte l'implémentation d'un système RAG ?
Pour une mise en œuvre basique, les coûts varient généralement entre 15 000 et 50 000 dollars. Ce budget couvre l'infrastructure cloud, les bases de données vectorielles et surtout le temps d'ingénierie nécessaire pour nettoyer et structurer les données sources.
L'ancrage ralentit-il les réponses du LLM ?
Oui, légèrement. L'étape supplémentaire de recherche dans la base de connaissances ajoute une latence, généralement comprise entre 100 et 500 millisecondes. Cependant, cette augmentation est souvent acceptable compte tenu du gain significatif en précision et en fiabilité.
9 Commentaires
Therese Sandfeldt
Super article ! 🤩 J'ai testé un RAG basique sur mes docs internes et ça change tout pour la fiabilité. Par contre, la partie "maintenance" me fait un peu peur... 😅 Si on oublie de mettre à jour les embeddings, on retourne vite dans le flou, non ?
Camille Bonner
Trop beau pour être vrai comme d'hab avec ces chiffres "industriels" qui sortent de nulle part.
On te vend du rêve avec des stats à 80% d'adoption en 2026 alors que 90% des POCs échouent faute de données propres. C'est pas une question de techno, c'est une question de gouvernance des données, point. Les boîtes vont continuer à halluciner parce qu'elles ne veulent pas payer le prix fort pour nettoyer leurs bases legacy. 🙄
Nicolas Poizot
Je rejoins l'analyse sur la nécessité absolue de structurer les sources avant même de penser à l'intégration vectorielle, car sans une ontologie claire ou au moins un schéma de données robuste, le retrieval devient simplement une recherche de bruit aléatoire plutôt qu'une récupération sémantique pertinente.
En tant que mentor technique, je vois trop souvent des équipes sauter directement à l'étape Pinecone/Weaviate sans avoir défini ce qu'est une "entité" valide dans leur contexte métier, ce qui conduit inévitablement à des réponses hallucinées malgré l'ancrage théorique.
Il faut considérer que le coût mentionné de 15k-50k dollars est souvent sous-estimé si l'on inclut le temps humain nécessaire pour annoter et valider les jeux de données initiaux, une tâche ingrate mais cruciale pour la qualité finale du système.
La granularité dont vous parlez est effectivement la clé, mais elle demande une refonte profonde des workflows de création de contenu interne, ce qui crée souvent des résistances culturelles plus fortes que les défis techniques eux-mêmes.
Alexis Petty-Rodriguez
Ah, les benchmarks industriels... 🙄
Sérieusement, qui a validé ces "30 à 50 %" ? Parce que dans mon expérience, si tu ne nettoies pas tes PDF (oui, ceux avec les tableaux cassés et les en-têtes répétitifs), ton RAG va halluciner *plus* vite qu'un LLM seul, juste parce qu'il croit que ses bêtises sont sourcées.
Bref, joli post, mais ne laissez pas vos CFOs croire que c'est magique. C'est de l'ingénierie de données déguisée en IA.
Maxime Thebault
C'est vraiment crucial !!!
La latence est le vrai sujet, à mon avis... On parle de 500ms, mais dans certains cas d'usage temps réel, c'est déjà trop long... Il faut optimiser les index, vraiment... Sinon, l'expérience utilisateur souffre, et puis, on perd tout l'intérêt de la réactivité...
Emmanuel Soh
Le coût d'entrée me terrifie un peu honnêtement. 15k minimum pour commencer ? Et encore, c'est pour quoi exactement ? Juste l'infra ou aussi les devs ? Ça sent le gouffre financier pour les petites structures. Je préfère rester prudent là-dessus.
laetitia betton
L'aspect philosophique est fascinant ici : nous tentons d'ancrer une intelligence probabiliste dans un monde déterministe.
En utilisant des bases structurées, nous créons une sorte de "vérité négociée" entre le modèle et l'humain. Cela pose la question de la responsabilité éthique : si le LLM cite une source erronée présente dans notre base, qui est responsable ? Le développeur, le data scientist ou l'auteur du document initial ? 🤔
La confiance ne se décrète pas, elle se construit par la transparence radicale des sources, comme le souligne très bien l'article. C'est un changement de paradigme majeur.
Mohamed Maiga
Excellent rappel sur l'importance de la qualité des données sources. :)
En Afrique francophone, nous avons souvent des problèmes de fragmentation des données (papier vs numérique). Un RAG bien conçu pourrait justement aider à consolider ces informations éparses si l'infrastructure cloud est accessible. :)
Pensez-vous que les modèles open-source locaux (comme Mistral) seront meilleurs candidats pour l'ancrage que les gros API américains, vu les enjeux de souveraineté des données ? ;)
Camille Bonner
@Nicolas Poizot Tu as raison sur le fond mais tu es beaucoup trop doux avec les managers qui pensent que "brancher une API" suffit.
@Mohamed Maiga La souveraineté est un argument marketing pour vendre du local, mais techniquement, si ta base est sale, ton modèle local hallucinera tout autant, juste plus lentement et sur ta propre machine. ;) Pas de magie locale.