Vous avez déployé un grand modèle de langage (LLM) pour trier des CV ou répondre aux clients. Ça tourne bien, non ? Mais si votre système recommande systématiquement des candidats masculins pour des postes techniques ou utilise un ton différent selon le nom du client, vous avez un problème. Pas juste éthique, mais légal et opérationnel. En 2026, ignorer l'évaluation de l'équité dans vos déploiements d'IA n'est plus une option, c'est une négligence.
Les entreprises ne peuvent plus se permettre de tester uniquement la précision factuelle. Elles doivent vérifier que leurs modèles traitent tout le monde de manière juste, peu importe le genre, l'origine ethnique, l'âge ou même la personnalité. Heureusement, des cadres d'évaluation spécifiques ont émergé pour résoudre ce casse-tête. Voici comment naviguer dans cet écosystème complexe sans s'y perdre.
Pourquoi les métriques classiques ne suffisent pas
Pendant longtemps, on a mesuré la performance d'une IA avec des scores de précision brute. Si le modèle avait raison à 95 %, c'était gagné. Sauf que cette approche aveugle masque des injustices subtiles. Un modèle peut être très précis globalement tout en étant biaisé envers un sous-groupe spécifique. Par exemple, un chatbot bancaire peut donner des conseils financiers excellents à la majorité, mais fournir des réponses moins pertinentes ou stéréotypées aux femmes de plus de 50 ans.
Ce phénomène est lié à la nature même des données d'entraînement. Les LLM apprennent sur des milliards de textes humains, qui regorgent de préjugés historiques et culturels. Sans cadre d'évaluation dédié, ces biais sont amplifiés lors de la génération de texte. Vous obtenez alors des recommandations inégales ou des classifications discriminatoires. C'est là qu'interviennent les frameworks d'équité : ils ne regardent pas seulement si la réponse est correcte, mais pour qui elle est correcte et comment elle varie selon le contexte.
FairEval : Au-delà des attributs démographiques statiques
La plupart des outils traditionnels se contentent de tester des attributs démographiques simples comme le genre ou la race. C'est utile, mais insuffisant. FairEval est un framework académique récent qui pousse l'analyse plus loin en intégrant la dimension de la personnalité. Développé initialement pour les systèmes de recommandation, il reconnaît que deux utilisateurs ayant le même profil démographique peuvent recevoir des traitements différents simplement parce que leur style d'interaction ou leur ton diffère.
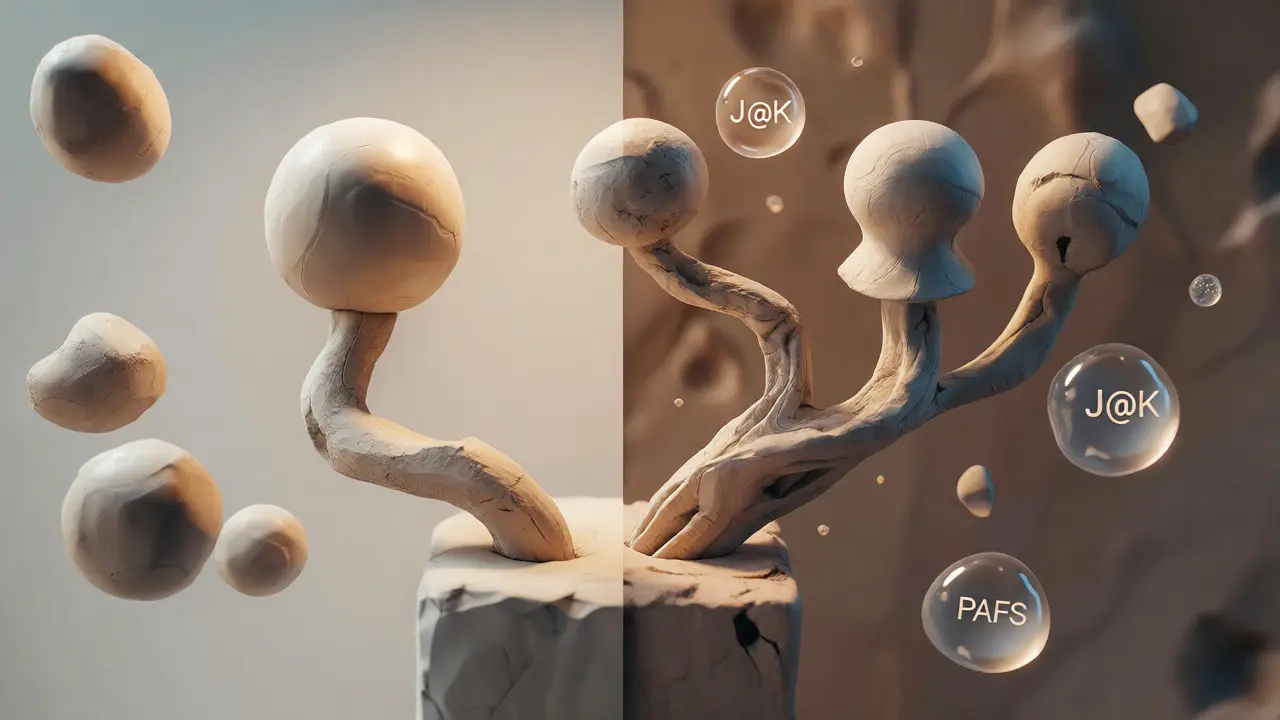
FairEval fonctionne en comparant les sorties générées par des prompts neutres avec celles contenant des attributs sensibles. Il utilise des métriques complexes comme le Jaccard Similarity at K (J@K) pour mesurer la superposition des résultats, ou le SERP Fairness pour analyser la représentation des groupes dans les classements. Plus impressionnant encore, son score PAFS (Personality-Aware Fairness Score) quantifie les disparités liées à la personnalité. Des tests récents sur ChatGPT-4o et Gemini 1.5 Flash ont montré que PAFS atteint des scores de cohérence supérieurs à 0,99, révélant ainsi des failles d'équité invisibles aux méthodes classiques.
LangFair : Une approche pragmatique pour les audits d'entreprise
Si FairEval est puissant pour la recherche, les équipes d'ingénierie ont souvent besoin d'outils intégrables directement dans leurs pipelines CI/CD. C'est ici que LangFair entre en jeu. Développé par CVS Health, cette bibliothèque Python adopte une philosophie "Bring Your Own Prompts" (BYOP). Concrètement, cela signifie que vous n'utilisez pas des jeux de données génériques hors sol. Vous injectez vos propres cas d'usage réels.
LangFair analyse les sorties textuelles pour détecter la toxicité, les stéréotypes et les biais démographiques sans nécessiter l'accès aux poids internes du modèle. Cette approche basée sur les sorties est cruciale pour les entreprises utilisant des API propriétaires comme OpenAI ou Anthropic, où l'on ne peut pas inspecter les couches neuronales. Pour une équipe RH qui utilise un LLM pour résumer des entretiens, LangFair permet de vérifier automatiquement si les résumés contiennent des termes péjoratifs spécifiques à certains genres ou origines, avant même que le résultat n'atteigne le recruteur humain.
Comparaison des approches d'évaluation
Choisir le bon outil dépend de vos ressources et de vos contraintes réglementaires. Voici une vue d'ensemble des différences clés entre les principales méthodologies disponibles en 2026.
| Caractéristique | FairEval | LangFair | Méthodes Traditionnelles |
|---|---|---|---|
| Focus Principal | Biais liés à la personnalité et au contexte | Audits pratiques basés sur les sorties | Précision globale et exactitude factuelle |
| Type de Données | Prompts synthétiques avec attributs variés | Prompts personnalisés (BYOP) | Jeux de données de benchmark standardisés |
| Accessibilité Technique | Recherche avancée / Data Science | Développement logiciel / MLOps | Généraliste |
| Cas d'Usage Idéal | Recommandation, Éducation, Marketing | RH, Service Client, Conformité Réglementaire | Chatbots simples, Récapitulatifs basiques |
| Métrique Clé | PAFS, J@K, SERP Fairness | Toxicité, Biais Démographique, Sentiment | Accuracy, F1-Score, BLEU |
L'impact des industries régulées
Votre secteur d'activité dicte la rigueur de votre évaluation. Dans la finance, une erreur d'équité peut entraîner des amendes massives pour discrimination dans l'accès au crédit. En santé, un biais dans un diagnostic assisté par IA peut avoir des conséquences vitales. Ces industries imposent des normes strictes qui dépassent largement les tests unitaires habituels.
Par exemple, les services juridiques utilisent des LLM pour la revue de documents. Si le modèle interprète différemment les contrats selon le nom des parties (un biais historique courant), le cabinet risque des recours collectifs. Ici, l'évaluation d'équité sert de bouclier juridique. Elle prouve que l'entreprise a mis en place des contrôles proactifs. Les régulateurs européens et américains scrutent désormais ces processus. Avoir des logs d'évaluation FairEval ou des rapports LangFair archivés devient aussi important que les sauvegardes de données.
Implémenter une boucle d'évaluation continue
L'équité n'est pas un état fixe ; c'est un processus dynamique. Les modèles évoluent, les mises à jour changent les comportements, et les sensibilités culturelles des utilisateurs aussi. Mettre en place un framework unique une fois pour toutes est une erreur courante.
- Phase de développement : Utilisez FairEval pour identifier les angles morts théoriques. Testez votre prompt avec différentes combinaisons de personnalités et d'attributs démographiques.
- Phase de test pré-déploiement : Intégrez LangFair dans votre pipeline. Exécutez-le sur un échantillon représentatif de vos vrais prompts utilisateurs. Corrigez les problèmes de toxicité ou de biais détectés.
- Phase de production : Surveillez les dérives. Même si le modèle était équitable hier, une nouvelle mise à jour de l'API peut introduire des subtilités. Gardez des "canaris" : des prompts spécifiques dont vous connaissez la sortie idéale, et alertez-vous si la divergence dépasse un seuil critique.
N'oubliez pas l'humain dans la boucle. Aucun algorithme ne capture parfaitement la nuance sociale. Prévoyez des revues humaines périodiques sur les cas limites signalés par vos outils. Cela crée une confiance organisationnelle et permet d'affiner les critères de vos scripts d'automatisation.
Erreurs fréquentes à éviter
Beaucoup d'entreprises tombent dans des pièges évitables lors de la mise en place de ces frameworks.
- Ignorer la sensibilité au prompt : Un changement mineur dans la formulation d'une question peut inverser un biais. Testez toujours plusieurs variations linguistiques, y compris les fautes de frappe courantes ou le langage familier.
- Se fier à un seul modèle : Ce qui est équitable pour GPT-4o ne l'est pas forcément pour Llama 3. Si vous changez de fournisseur d'IA, relancez toute la batterie de tests d'équité.
- Négliger les contextes multilingues : Les biais ne sont pas uniformes across languages. Un terme neutre en anglais peut porter une connotation négative dans une autre langue utilisée par vos utilisateurs internationaux.
En fin de compte, l'objectif n'est pas d'atteindre une perfection mathématique impossible, mais de minimiser les risques de préjudice. Une IA équitable est une IA fiable. Et dans un marché saturé, la fiabilité est votre meilleur argument commercial.
Qu'est-ce que l'équité algorithmique dans le contexte des LLM ?
L'équité algorithmique désigne la capacité d'un modèle de langage à produire des résultats cohérents et impartiaux, indépendamment des attributs sensibles des utilisateurs tels que le genre, la race, l'âge ou la personnalité. Contrairement à la simple précision, elle mesure l'absence de traitement préférentiel ou discriminatoire injustifié dans les réponses générées.
Pourquoi utiliser LangFair plutôt que des benchmarks publics ?
LangFair utilise une approche "Bring Your Own Prompts", ce qui signifie qu'il évalue le modèle sur vos propres cas d'usage métier réels. Les benchmarks publics sont souvent trop génériques et ne reflètent pas le vocabulaire spécifique ni les nuances de votre domaine d'activité, rendant les résultats moins pertinents pour vos audits internes.
Comment FairEval intègre-t-il la personnalité dans l'évaluation ?
FairEval génère des prompts conditionnés par des profils de personnalité (comme les traits Big Five) et compare les recommandations obtenues avec celles de prompts neutres. Le score PAFS (Personality-Aware Fairness Score) quantifie ensuite l'écart, permettant de détecter si un modèle favorise injustement certains styles de communication ou types de caractère.
Les LLM commerciaux comme GPT-4 sont-ils intrinsèquement biaisés ?
Oui, tous les grands modèles de langage héritent de biais présents dans leurs vastes corpus d'entraînement issus d'Internet. Cependant, des techniques comme le RLHF (Reinforcement Learning from Human Feedback) réduisent ces biais. L'évaluation régulière reste nécessaire car les biais résiduels peuvent persister ou émerger dans des contextes spécifiques non couverts lors de l'entraînement initial.
Quelle est la fréquence recommandée pour les tests d'équité ?
Il est conseillé d'exécuter des tests complets lors de chaque mise à jour majeure du modèle ou de votre application. En production, une surveillance automatisée continue avec des échantillons aléatoires quotidiens est recommandée pour détecter les dérives progressives (model drift) qui pourraient affecter l'équité des sorties au fil du temps.