Imaginez acheter un yaourt sans savoir s'il contient du lait, des allergènes ou si le sucre ajouté est synthétique. Vous seriez méfiant, non ? L'intelligence artificielle générative souffre exactement du même problème. Les utilisateurs, les développeurs et les régulateurs consomment ces modèles sans connaître leurs ingrédients internes, leurs biais cachés ou leurs limites réelles. C'est là qu'interviennent les outils de transparence pour l'IA, comme les fiches modèles (Model Cards) et les déclarations de données. Ces documents ne sont pas juste de la paperasse administrative ; ils sont essentiels pour garantir que l'IA reste fiable, éthique et conforme aux nouvelles réglementations comme l'EU AI Act.
Pourquoi avons-nous besoin de "étiquettes nutritionnelles" pour l'IA ?
Le concept de fiche modèle est né d'un constat simple : les modèles d'apprentissage automatique sont souvent des boîtes noires. Sans documentation standardisée, il est impossible de savoir pourquoi un modèle a pris une décision spécifique ou dans quel contexte il risque de se tromper. Les fiches modèles agissent comme des étiquettes nutritionnelles. Elles détaillent les "ingrédients" (les données), la méthode de préparation (l'entraînement) et les valeurs nutritives (les performances). Selon les principes établis par des organisations comme Google et Red Hat, cette approche permet à tous les acteurs du cycle de vie de l'IA - des créateurs aux patients utilisant des outils médicaux - de prendre des décisions éclairées.
La transparence n'est plus une option sympathique, c'est une exigence légale et éthique. L'Union européenne, avec son règlement sur l'IA, impose désormais aux développeurs de rendre disponibles certaines informations aux fournisseurs en aval. Si vous déployez une IA qui aide à diagnostiquer une maladie, vous devez pouvoir prouver comment elle a été entraînée et quelles sont ses limites connues. Sans cela, vous risquez non seulement des sanctions, mais aussi une perte de confiance totale de vos utilisateurs.
Décortiquer la Fiche Modèle : Ce qu'elle doit contenir
Une bonne fiche modèle ne se contente pas de dire "ce modèle est bon". Elle répond à des questions précises sur la provenance et la fiabilité. Prenons l'exemple d'Esri, qui utilise des cartes de transparence pour ses produits ArcGIS. Leur structure couvre cinq domaines critiques : la fonctionnalité, les sources de données, la validation, la confidentialité et les limitations connues. Cette rigueur est nécessaire car les données publiques utilisées pour entraîner les IA peuvent parfois inclure des informations privées ayant fuité lors de violations antérieures.
Voici les composants essentiels d'une déclaration complète :
- Sources des données : D'où viennent les données ? Sont-elles éthiques ? Ont-elles été collectées avec consentement ?
- Classification de la confidentialité : Les données contiennent-elles des éléments sensibles (santé, finance) ?
- Métriques de performance : Précision, rappel, taux d'erreur. Mais attention, ces chiffres doivent être contextualisés.
- Biais connus : Le modèle favorise-t-il certains groupes démographiques au détriment d'autres ?
- Cas d'usage hors périmètre : Dans quels scénarios le modèle ne doit-il absolument pas être utilisé ?
Par exemple, un modèle conçu pour générer du code Python peut exceller sur des scripts simples mais échouer lamentablement sur des architectures complexes. La fiche modèle doit signaler cette limite explicitement, sinon les utilisateurs feront des suppositions dangereuses.
L'évolution vers les Cartes de Système d'IA
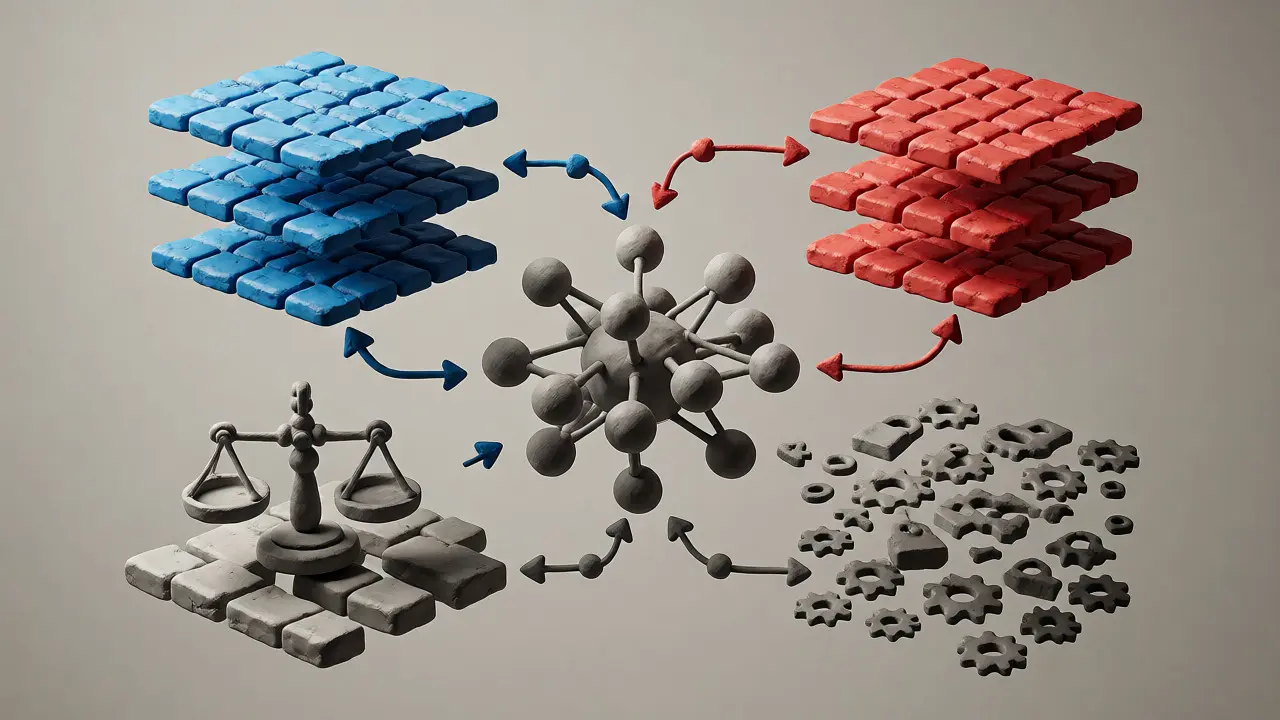
Les fiches modèles classiques ont leurs limites. Elles documentent souvent un modèle isolé, alors que les systèmes modernes utilisent plusieurs modèles combinés. C'est pourquoi Red Hat a introduit les Cartes de Système d'IA. Cette approche va plus loin en documentant l'architecture entière, y compris les diagrammes de flux, les modèles constitutifs et les journaux de sécurité. L'idée est de permettre à la communauté open source d'auditer la pile technologique complète, un peu comme on révise le code sur GitHub.
Cette évolution répond à un besoin crucial : la vérification indépendante. Avec des licences ouvertes comme CC BY 4.0 et des schémas standardisés, ces cartes deviennent remixables. Les entreprises peuvent automatiser les vérifications de politique et comparer côte à côte des systèmes concurrents. Pour un acheteur d'entreprise, cela signifie passer des affirmations marketing vagues à des faits objectifs. Vous pouvez voir exactement quels correctifs de sécurité ont été appliqués récemment ou quelles sources de données ont été augmentées.
| Critère | Fiche Modèle (Model Card) | Carte de Système (System Card) |
|---|---|---|
| Portée | Un seul modèle algorithmique | L'ensemble de la chaîne de traitement et des composants |
| Audience principale | Développeurs, Data Scientists | Architectes système, Auditeurs, Communauté Open Source |
| Contenu technique | Métriques de précision, biais statistiques | Diagrammes d'architecture, dépendances logicielles, changelogs |
| Objectif clé | Comprendre les capacités du modèle | Auditer la sécurité et la robustesse globale |
Spécificités du secteur médical et réglementaire
Dans le domaine de la santé, la transparence prend une dimension vitale. Une recherche publiée dans PMC souligne que les fiches modèles médicales doivent répondre aux besoins spécifiques des patients, des médecins et des établissements. Un patient ne comprendra pas une matrice de confusion, mais il a besoin de savoir si le diagnostic assisté par IA est adapté à sa population cible (âge, sexe, origine ethnique).
Les exigences de l'EU AI Act sont particulièrement strictes ici. Les développeurs d'IA à usage général (GPAI) doivent fournir des informations suffisantes aux fabricants de dispositifs médicaux pour qu'ils puissent obtenir leur certification CE. Cela crée une chaîne de responsabilité où chaque maillon doit transmettre les données pertinentes. Par exemple, si un modèle a été entraîné principalement sur des données européennes, il peut avoir des biais importants lorsqu'il est déployé en Asie ou en Afrique. Cette information doit figurer clairement dans la déclaration d'utilisation.
Les pièges courants de la fausse transparence
Attention au syndrome de la case cochée. Beaucoup d'entreprises publient des fiches modèles pour se conformer à la réglementation, mais rendent ces documents illisibles pour le grand public. L'Association internationale des professionnels de la vie privée (IAPP) note que les déclarations peuvent être techniquement vraies mais obscurcir la réalité des données "publiquement disponibles", qui incluent souvent des fuites de données passées.
Un autre piège est le manque d'intégration avec les processus opérationnels. Une fiche modèle statique PDF devient obsolète dès la première mise à jour du modèle. Les solutions modernes, comme celles mises en œuvre chez Datatonic, intègrent l'explicabilité directement dans des tableaux de bord interactifs. Ils utilisent BigQuery pour stocker les métadonnées automatiquement et génèrent des graphiques montrant l'importance de chaque paramètre dans une prédiction. Cette approche dynamique est bien plus utile qu'un document figé.
Comment implémenter une stratégie de transparence efficace ?
Si vous lancez un projet d'IA générative, ne laissez pas la documentation pour la fin. Intégrez-la dès le départ. Voici une checklist pratique pour éviter les erreurs courantes :
- Audit des données : Identifiez les sources potentiellement problématiques (données scrapper sans licence claire).
- Test de biais : Évaluez les performances du modèle sur différents sous-groupes démographiques avant la publication.
- Langage clair : Rédigez une version simplifiée pour les non-experts et une version technique pour les ingénieurs.
- Versionnage : Assurez-vous que chaque version du modèle a sa propre fiche associée.
- Feedback loop : Permettez aux utilisateurs de signaler des comportements inattendus qui pourraient nécessiter une mise à jour de la fiche.
La transparence n'est pas un coût, c'est un investissement dans la durabilité de votre produit. À mesure que nous avançons en 2026, avec l'entrée en vigueur progressive des normes mondiales, les entreprises qui maîtrisent ces outils gagneront la confiance des marchés institutionnels et des consommateurs avertis.
Qu'est-ce qu'une fiche modèle (Model Card) exactement ?
Une fiche modèle est un document structuré qui fournit des informations clés sur un modèle d'IA, telles que ses performances, ses limites, ses biais potentiels et les données utilisées pour son entraînement. Elle sert à promouvoir la transparence et la responsabilité, permettant aux utilisateurs de comprendre comment le modèle fonctionne et quand il peut échouer.
Pourquoi la transparence est-elle obligatoire pour l'IA générative ?
Des réglementations comme l'EU AI Act exigent des niveaux élevés de transparence pour les systèmes d'IA à haut risque et les modèles généraux. Cela vise à protéger les droits fondamentaux, assurer la sécurité des utilisateurs et permettre une supervision humaine efficace. Sans transparence, il est difficile de détecter les biais discriminatoires ou les hallucinations fréquentes.
Quelle est la différence entre une fiche modèle et une carte de système ?
Une fiche modèle se concentre sur un algorithme unique (ses métriques, ses données). Une carte de système, comme celle proposée par Red Hat, documente l'architecture complète, incluant plusieurs modèles, les infrastructures, les flux de données et les mesures de sécurité globales. La carte de système offre une vue d'ensemble pour l'audit de sécurité et la maintenance opérationnelle.
Les petites entreprises peuvent-elles créer des fiches modèles ?
Oui, absolument. Il existe des modèles gratuits et des outils open source pour générer des fiches modèles. Même si vous utilisez une API externe, vous pouvez documenter comment vous configurez le modèle, quels filtres vous appliquez et quels cas d'usage vous recommandez. La transparence commence par l'honnêteté sur ce que vous savez et ce que vous ignorez.
Que faire si les données d'entraînement sont propriétaires ?
Vous n'avez pas toujours besoin de divulguer les données brutes. La fiche modèle peut décrire les types de données, les volumes approximatifs, les sources générales et les méthodes de nettoyage utilisées. L'important est de donner assez de contexte pour évaluer la fiabilité du modèle sans violer les secrets commerciaux ou la confidentialité des utilisateurs.