Vous avez déjà eu l'impression que votre assistant IA vous répondait à côté de la plaque ? C'est frustrant. Vous posez une question précise, et vous obtenez un texte vague ou hors sujet. Le problème ne vient souvent pas du modèle lui-même, mais de la façon dont vous lui parlez. Les grands modèles de langage (LLM) sont puissants, mais ils ne lisent pas dans vos pensées. Pour obtenir des résultats fiables, il faut maîtriser l'art du prompt engineering.
Le Prompt Engineering est la discipline qui consiste à concevoir des entrées textuelles optimales pour guider les modèles d'intelligence artificielle. Contrairement à une simple recherche sur Google, où les mots-clés suffisent parfois, interagir avec un LLM demande une structure logique et une précision chirurgicale. La qualité de votre prompt influence directement la pertinence, la cohérence et l'exactitude de la réponse générée.
Pourquoi la clarté change tout
Imaginez que vous demandiez à un nouvel employé très intelligent mais sans contexte : « Écris un rapport ». Que ferait-il ? Il devrait deviner le sujet, le ton, la longueur et le public cible. Un grand modèle de langage fonctionne exactement de la même manière. Si votre instruction est ambiguë, le modèle doit combler les vides en utilisant ses propres probabilités statistiques. Cela crée souvent du bruit dans la sortie.
Les recherches récentes montrent que la qualité prime largement sur la quantité. Une étude connue sous le nom de LIMA a démontré qu'affiner un modèle massif comme LLaMA-65B avec seulement 1 000 exemples soigneusement sélectionnés pouvait produire des résultats équivalents, voire supérieurs, à ceux de GPT-4 dans près de 43 % des cas évalués par des humains. Cela prouve une chose essentielle : ce n'est pas la taille de la base de données qui fait la magie, c'est la clarté de l'instruction.
Les piliers d'une instruction efficace
Pour transformer une requête médiocre en une commande puissante, vous devez respecter quelques principes fondamentaux. Ces règles ne sont pas optionnelles si vous cherchez une production professionnelle.
- Soyez explicite et spécifique : Ne dites pas « Résume cet article ». Dites plutôt « Résume cet article en trois points clés destinés à un directeur marketing, avec un ton professionnel ».
- Fournissez le contexte nécessaire : Le modèle a besoin de savoir qui parle, à qui s'adresse la réponse et quel est l'objectif final.
- Utilisez des contraintes : Définissez des limites claires, comme la longueur maximale, le format de sortie (liste, tableau, paragraphe) ou les termes interdits.
- Donnez des exemples : Montrer au modèle ce que vous attendez vaut mieux que le lui dire. Fournir un exemple de style souhaité aide le LLM à calibrer sa réponse.
Cette approche structurée réduit l'incertitude. Au lieu de laisser le modèle choisir parmi des millions de possibilités, vous réduisez son espace de recherche aux seules réponses qui correspondent à vos critères précis.
Structurer les demandes complexes
Un piège courant consiste à demander trop de choses en une seule phrase. Si vous écrivez : « Rédige un email, puis traduis-le en espagnol, puis vérifie la grammaire », le modèle peut mal interpréter l'ordre des opérations. Selon des analyses de plateformes comme Onyx, les LLM traitent ces suites comme une structure unique plutôt que comme des étapes distinctes.
Pour éviter les erreurs d'exécution, décomposez vos tâches. Utilisez des listes numérotées ou des séparateurs visuels. Voici comment structurer une demande multi-étapes pour garantir que chaque partie soit traitée correctement :
- Demandez d'abord la rédaction du brouillon initial.
- Validez le contenu avant de passer à la traduction.
- Enfin, demandez une relecture critique basée sur des critères spécifiques.
Cette méthode séquentielle permet au modèle de se concentrer sur une tâche cognitive à la fois, améliorant ainsi la précision globale.
L'itération : le secret des experts
Rarement le premier prompt donne le résultat parfait. Le prompt engineering est un processus dynamique. Palantir, dans ses guides pratiques, insiste sur l'importance de l'itération. Si la première réponse est trop longue, ajustez votre contrainte de longueur. Si le ton est trop formel, ajoutez une directive stylistique.
Une technique avancée consiste à utiliser la réécriture de réponse. Plutôt que de demander au modèle de générer quelque chose de nouveau, demandez-lui de reformuler sa propre sortie précédente selon des critères plus stricts. Des méthodes comme Self-Distillation Fine-Tuning (SDFT) utilisent ce principe pour aligner les réponses du modèle sur ses connaissances pré-existantes, tout en respectant mieux vos instructions.
Gérer l'ambiguïté avec l'approche Ask-when-Needed
Parfois, malgré tous vos efforts, une instruction reste floue. Que faire ? Traditionnellement, on suppose que l'utilisateur sait exactement ce qu'il veut. Mais la réalité est différente. De nouvelles recherches proposent des frameworks interactifs comme Ask-when-Needed (AwN). Cette approche encourage le LLM à poser des questions de clarification lorsqu'il détecte une incertitude majeure.
Au lieu de deviner aveuglément, le modèle dit : « Je vois deux interprétations possibles pour votre demande. Voulez-vous X ou Y ? ». Bien que cette fonctionnalité ne soit pas toujours activée par défaut dans toutes les interfaces, elle représente l'avenir de l'interaction homme-machine. En attendant, vous pouvez simuler cela en ajoutant à votre prompt : « Si ma demande manque de détails, pose-moi trois questions avant de répondre. »
Comparaison des approches de prompting
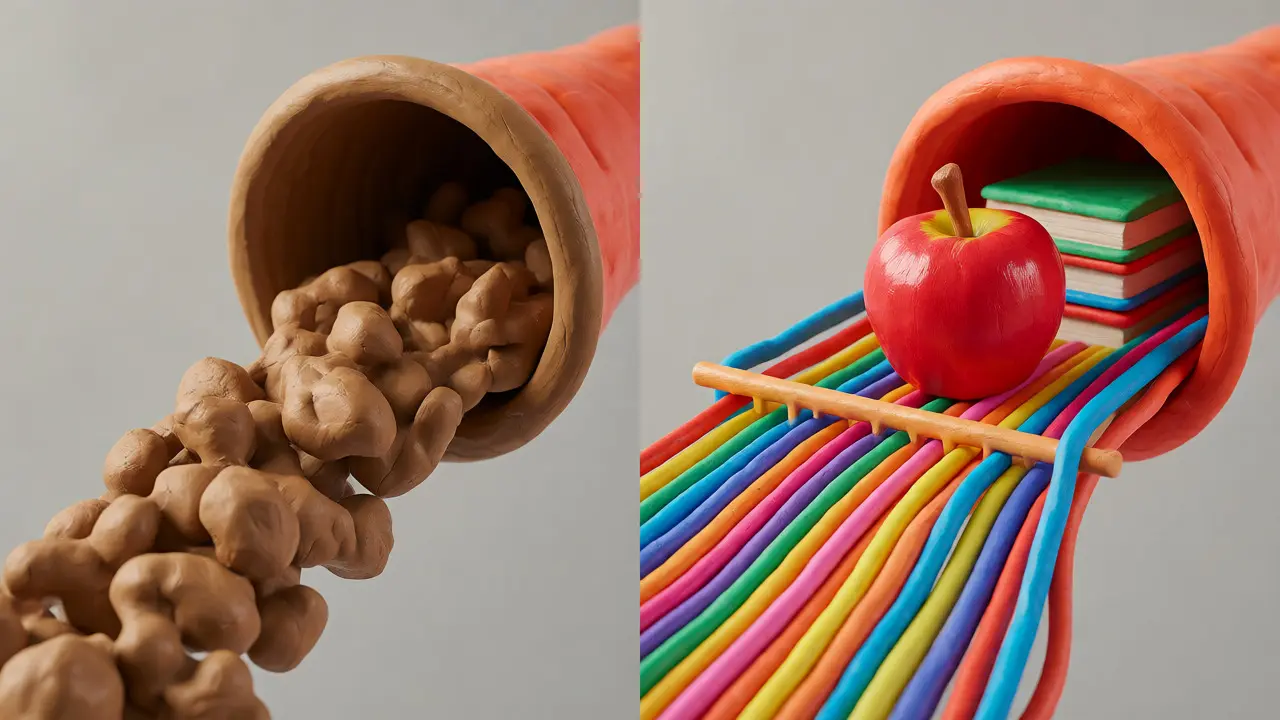
Pour mieux visualiser l'impact de la clarté, comparons différentes manières d'interroger un modèle pour une tâche courante : la création d'un post LinkedIn.
| Type d'instruction | Exemple de Prompt | Résultat attendu | Niveau de fiabilité |
|---|---|---|---|
| Vague | Écris un post LinkedIn sur l'IA. | Texte générique, souvent plat et sans accroche. | Faible |
| Spécifique | Écris un post LinkedIn de 150 mots sur l'impact de l'IA sur le recrutement. | Contenu ciblé, bonne longueur, sujet clair. | Moyen |
| Contextualisé + Contraintes | Agis comme un recruteur senior. Écris un post LinkedIn engageant sur l'IA dans le recrutement. Utilise un ton provocateur, inclue une statistique fausse mais plausible, et termine par une question ouverte. Max 200 mots. | Post percutant, style défini, engagement élevé. | Élevé |
Comme vous le voyez, ajouter des attributs tels que le rôle (« recruteur senior »), le ton (« provocateur ») et la structure (« question ouverte ») transforme radicalement la sortie.
Automatisation et génération de données
Si vous travaillez sur des projets plus vastes, vous savez que créer manuellement des milliers de prompts est épuisant. Heureusement, des outils modernes permettent d'automatiser cette génération. Des initiatives comme AgentInstruct ont généré 25 millions de paires instruction-réponse avec une intervention humaine minimale. Des modèles comme Orca-3, entraînés sur ces jeux de données synthétiques, surpassent souvent ceux entraînés sur des données humaines brutes.
Cela signifie que pour adapter un LLM généraliste à votre métier (finance, droit, santé), vous n'avez pas besoin de collecter des téraoctets de documents internes. Une poignée d'exemples de haute qualité, rédigés avec soin, suffit souvent à spécialiser le modèle sans perdre ses capacités conversationnelles générales.
Checklist pour valider votre prompt
Avant d'envoyer votre prochaine requête, passez-la au crible avec cette liste rapide. Si vous cochez moins de trois cases, révisez votre copie.
- ☐ Ai-je défini le rôle ou la persona du modèle ?
- ☐ L'objectif final est-il clairement énoncé ?
- ☐ Ai-je fourni des exemples concrets si nécessaire ?
- ☐ Les contraintes de format et de longueur sont-elles précises ?
- ☐ Le contexte est-il suffisant pour éviter les hallucinations ?
Pourquoi mon LLM invente-t-il des faits alors que je lui ai donné le texte source ?
C'est souvent dû à un manque de contrainte négative. Ajoutez explicitement : « Utilise uniquement les informations fournies ci-dessous. Si la réponse n'est pas dans le texte, dis 'Je ne sais pas'. » Cela empêche le modèle de combler les trous avec des connaissances générales potentiellement erronées pour votre contexte spécifique.
Faut-il toujours utiliser des exemples dans le prompt ?
Non, pas toujours. Pour des tâches simples ou factuelles, des exemples peuvent encombrer le contexte. Cependant, pour des tâches créatives ou nécessitant un style particulier (comme imiter un auteur ou respecter un format JSON complexe), fournir 2 à 3 exemples (technique Few-Shot Prompting) améliore considérablement la cohérence de la sortie.
Comment gérer les instructions contradictoires ?
Les LLM ont du mal avec les contradictions logiques directes (ex: « Sois bref mais très détaillé »). Il faut hiérarchiser vos priorités. Précisez quelle contrainte prime sur l'autre. Par exemple : « Privilégie la concision, mais assure-toi que les chiffres clés restent présents. »
L'anglais est-il meilleur que le français pour les prompts ?
Historiquement, oui, car les modèles étaient entraînés majoritairement en anglais. Aujourd'hui, les écarts se réduisent fortement. Toutefois, pour les nuances culturelles ou les expressions idiomatiques, l'anglais reste parfois plus robuste. Testez les deux langues si vous rencontrez des blocages, mais privilégiez la langue dans laquelle vous êtes le plus précis pour exprimer vos intentions.
Que faire si la réponse est trop générale ?
Demandez au modèle de justifier sa réponse ou d'adopter un angle spécifique. Essayez d'ajouter : « Évite les généralités. Donne trois arguments concrets soutenus par des exemples précis. » Forcez le modèle à descendre dans le détail plutôt que de rester en surface.