Vous avez une idée précise pour un assistant IA spécialisé, mais vous n'avez que quelques dizaines d'exemples annotés. Pas des milliers. Des dizaines. C'est le cauchemar classique du développeur ML moderne : votre entreprise possède des données sensibles (médicales, juridiques) ou simplement rares, et vous voulez adapter un grand modèle de langage (LLM) sans exploser votre budget GPU ni passer six mois à étiqueter des données. La bonne nouvelle ? Vous n'avez pas besoin de millions d'exemples. Grâce aux techniques de fine-tuning few-shot, vous pouvez adapter des géants comme LLaMA ou Mistral avec seulement 10 à 100 exemples, tout en gardant la performance proche de l'entraînement complet.
Mais attention, ce n'est pas magique. Le few-shot fine-tuning est un exercice d'équilibre délicat entre la quantité de données, la méthode d'adaptation et les ressources matérielles. Si vous faites une erreur sur le taux d'apprentissage ou si vos exemples sont biaisés, votre modèle hallucinera plus qu'il ne répondra. Dans cet article, nous allons décortiquer comment fonctionne réellement cette approche, quelles technologies utiliser (spoiler : LoRA et QLoRA), et comment éviter les pièges qui coûtent cher.
Pourquoi le fine-tuning traditionnel échoue quand les données manquent
Le fine-tuning classique consiste à entraîner l'intégralité des paramètres d'un modèle pré-entraîné sur un nouveau jeu de données. Pour un modèle de 7 milliards de paramètres, cela demande souvent 80 Go de VRAM et des milliers d'exemples. Si vous travaillez dans un domaine de niche, comme l'analyse de contrats juridiques spécifiques ou le diagnostic médical rare, obtenir ces milliers d'exemples annotés par des experts peut coûter des fortunes et prendre des mois.
C'est là que le concept de "scarce data" (données rares) prend tout son sens. Les réglementations comme le RGPD en Europe ou HIPAA aux États-Unis limitent strictement le partage de données médicales ou financières. Vous ne pouvez pas simplement envoyer vos données brutes chez Google ou Meta pour un entraînement massif. De plus, collecter des données pour des tâches très spécifiques (comme la classification de tickets de support technique internes) est prohibitif.
Le few-shot fine-tuning résout ce problème en changeant la stratégie. Au lieu de modifier tous les poids du réseau neuronal, on utilise des méthodes d'Parameter-Efficient Fine-Tuning (PEFT) qui ne touchent qu'une infime fraction des paramètres, généralement entre 0,01 % et 20 %. Cela réduit non seulement le besoin en mémoire, mais aussi le risque de surapprentissage (overfitting) lorsque le nombre d'exemples est faible.
Les héros technologiques : LoRA et QLoRA expliqués simplement
Si vous devez retenir deux acronymes, ce sont LoRA et QLoRA. Ils ont révolutionné le domaine depuis 2021-2023 en rendant l'adaptation de modèles accessible sur des cartes graphiques grand public.
LoRA (Low-Rank Adaptation)
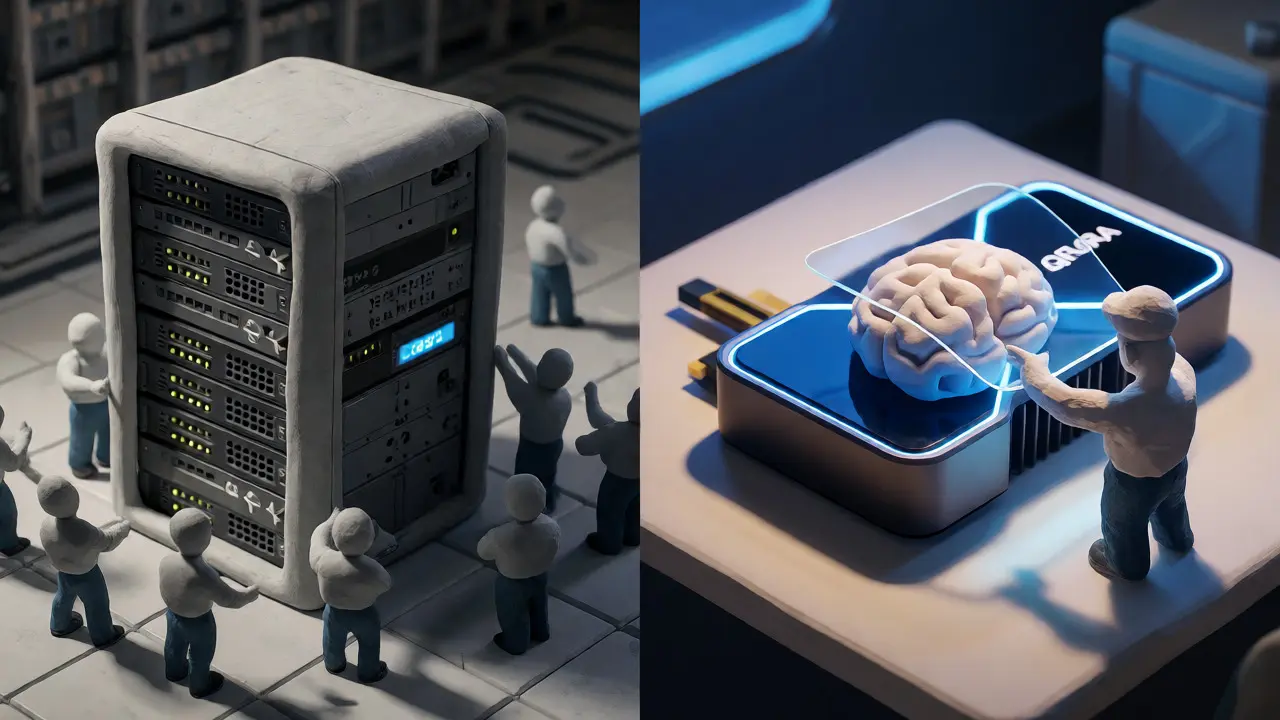
Imaginez que vous deviez ajuster une image haute résolution pixel par pixel (le fine-tuning classique). C'est lent et coûteux. LoRA propose une autre approche : au lieu de modifier l'image entière, vous superposez un petit filtre transparent que vous ajustez. Techniquement, LoRA décompose les mises à jour des poids en matrices de rang faible. Selon l'article fondateur de Hu et al. (2021), cela permet de réduire le nombre de paramètres entraînables jusqu'à 10 000 fois moins que l'approche complète.
Concrètement, pour adapter un modèle LLaMA-7B, vous n'entraînez plus 7 milliards de paramètres, mais quelques millions seulement. Le résultat ? Une réduction massive de la mémoire nécessaire et une vitesse d'entraînement fulgurante. Mais surtout, vous obtenez environ 92 à 97 % des performances d'un fine-tuning complet, selon les analyses techniques de SuperAnnotate (2025).
QLoRA (Quantized Low-Rank Adaptation)
En 2023, Dettmers et ses collègues ont poussé le concept plus loin avec QLoRA. Cette technique combine LoRA avec une quantification 4-bit. En gros, elle comprime les poids du modèle pré-entraîné pour qu'ils occupent beaucoup moins de place en mémoire, tout en conservant leur précision mathématique grâce à une méthode appelée NormalFloat4.
L'impact est énorme. Là où un fine-tuning complet de LLaMA-65B nécessitait 780 Go de mémoire (soit plusieurs serveurs GPU), QLoRA permet de le faire sur une seule carte NVIDIA RTX 4090 avec 24 Go de VRAM. C'est la différence entre payer 12 000 $ par tâche sur AWS et 300 $. Pour les startups et les équipes R&D, c'est un changement de paradigme économique.
| Méthode | Paramètres modifiés | Besoins mémoire (approx.) | Performance vs Full FT | Idéal pour |
|---|---|---|---|---|
| Fine-tuning Complet | 100% | > 80 Go (pour 7B) | 100% (Référence) | Domaines larges, gros budgets |
| LoRA | < 1% | ~ 20-40 Go | 92-97% | Adaptation de style/tâche spécifique |
| QLoRA | < 1% | ~ 24 Go (RTX 4090) | ~ 99% (sur certains benchmarks) | Modèles géants (65B+) sur hardware limité |
| In-Context Learning | 0% | Variable (contexte) | 82-88% | Prototypage rapide, zéro entraînement |
La recette critique : Hyperparamètres et qualité des données
Avoir la bonne technologie ne suffit pas. Avec peu de données, chaque exemple compte double, voire triple. Voici les règles d'or issues de l'expérience terrain et des revues scientifiques récentes (PMC 2025).
- Le taux d'apprentissage (Learning Rate) : C'est le paramètre le plus critique. Contrairement au fine-tuning complet où l'on peut être plus flexible, ici il faut viser bas. Une plage optimale se situe entre 1e-5 et 5e-4. Si vous dépassez 2e-4, préparez-vous à voir votre convergence devenir instable dans près de 50 % des cas, selon les trackers GitHub des bibliothèques PEFT.
- Le nombre d'époques : Ne cherchez pas à entraîner trop longtemps. Avec 50 exemples, 3 à 10 époques suffisent souvent. Au-delà, le modèle commence à mémoriser les exemples plutôt qu'à généraliser, augmentant le taux d'hallucination.
- La taille du batch : Gardez-la petite, entre 4 et 16. Cela introduit un bruit régularisant naturel qui aide le modèle à ne pas se figer sur des patterns trop spécifiques de votre petit jeu de données.
Un point crucial soulevé par Edward Hu, co-créateur de LoRA, lors de sa conférence NeurIPS 2023 : "Moins de 10 exemples de haute qualité donnent souvent des résultats sous-optimaux." Il recommande un minimum de 50 exemples soigneusement sélectionnés par classe pour les tâches de classification. En dessous de ce seuil, la performance devient extrêmement sensible à la sélection des exemples. Un seul exemple aberrant peut fausser tout le modèle.
Quand le few-shot fine-tuning brille (et quand il échoue)
Il est vital de comprendre les limites de cette approche. Ce n'est pas une solution universelle.
Les cas de succès probants
Le few-shot excelle dans les domaines verticaux spécialisés où la structure de la tâche reste connue, mais le vocabulaire ou le format change. Par exemple, Partners HealthCare a amélioré la précision de la résuméption de notes cliniques de 22,7 % en utilisant cette méthode. Pourquoi ? Parce que le modèle savait déjà "parler anglais" et "comprendre la grammaire", il avait juste besoin d'apprendre le jargon médical spécifique et le format de sortie attendu.
De même, une startup fintech documentée sur Medium a réduit ses coûts d'adaptation de 18 500 $ à 460 $ par tâche pour la détection de fraude, maintenant 94,3 % de la performance d'un entraînement complet. Le gain financier est direct, et la rapidité de mise sur le marché est inestimable.
Les pièges à éviter
Le few-shot fine-tuning lutte lorsqu'il s'agit d'injecter des connaissances totalement nouvelles ou de changer radicalement de langue. Une étude multilingue de Google Research (2025) montre que pour l'adaptation à une nouvelle langue, le few-shot atteint seulement 63,2 % de précision contre 81,4 % pour le fine-tuning complet. Le modèle manque de profondeur pour internaliser une nouvelle syntaxe et un nouveau lexique avec si peu d'exemples.
Autre danger : l'hallucination. Stanford a découvert que les modèles few-shot présentent un taux d'hallucination 18,3 % supérieur aux modèles entièrement affinés face à des requêtes hors distribution. Autrement dit, si vous posez une question légèrement différente de celles apprises, le modèle inventera une réponse plausible mais fausse plus facilement. Heureusement, un réglage fin des hyperparamètres peut réduire cet écart à 6,2 %, prouvant que la rigueur paie.
Guide pratique pour démarrer votre projet
Prêt à vous lancer ? Voici les étapes concrètes, basées sur les workflows utilisés par les équipes chez Mayo Clinic et Hugging Face.
- Sélection des exemples (Data Curation) : Consacrez 8 à 40 heures à choisir vos exemples. Ils doivent être représentatifs, variés et exempts de bruit. Utilisez un expert du domaine. Ne prenez pas 100 exemples similaires ; privilégiez la diversité des cas limites.
- Configuration de l'environnement : Utilisez la bibliothèque Hugging Face PEFT. Elle est devenue le standard de facto, avec 1,8 million de vues mensuelles sur sa documentation. Configurez LoRA avec un rang (rank) entre 4 et 64. Commencez bas (r=8) et augmentez si la performance plafonne.
- Entraînement avec Early Stopping : Lancez l'entraînement avec un mécanisme d'arrêt anticipé. Surveillez la perte sur un petit jeu de validation séparé. Dès que la perte de validation remonte, arrêtez-vous. Ne forcez pas les époques.
- Évaluation rigoureuse : N'utilisez pas uniquement des métriques automatiques. Faites une revue humaine sur un échantillon de 20-30 sorties générées. Vérifiez spécifiquement les hallucinations et le respect du format demandé.
Le temps d'apprentissage varie de 2 à 6 semaines pour un ingénieur ML familier avec PyTorch ou TensorFlow. La courbe d'apprentissage la plus raide concerne justement l'optimisation des hyperparamètres et la préparation des données.
Perspectives d'avenir et adoption industrielle
Le marché évolue vite. Gartner prévoit que 78 % des déploiements d'entreprise utiliseront des techniques PEFT d'ici 2026, contre 42 % en 2024. Pourquoi ? Parce que les coûts baissent et que les outils deviennent plus simples. Hugging Face a intégré le support natif de QLoRA dans Transformers v4.38, réduisant la complexité d'implémentation de 60 %.
Des innovations comme le Dynamic Rank Adjustment (annoncé par Meta AI en janvier 2026) promettent d'automatiser encore plus le processus, optimisant dynamiquement la capacité d'adaptation pendant l'entraînement. À terme, on s'oriente vers des systèmes d'apprentissage actif qui sélectionneront automatiquement les 10 exemples les plus informatifs parmi un corpus non annoté, réduisant encore le besoin d'intervention humaine.
Si vous êtes dans la santé, le droit ou la finance, le few-shot fine-tuning n'est plus une option expérimentale, c'est la voie pragmatique. Il respecte la confidentialité des données, minimise les coûts informatiques et offre une performance suffisante pour la plupart des applications métier critiques.
Combien d'exemples sont nécessaires pour un fine-tuning few-shot efficace ?
Bien que le terme "few-shot" suggère quelques exemples, la recherche actuelle (Google Research, 2025) indique qu'il faut idéalement au moins 50 exemples de haute qualité par classe pour les tâches de classification. En dessous de 20 exemples, le risque de surapprentissage et de sensibilité extrême aux choix des données augmente considérablement. Pour les tâches génératives complexes, viser 100 à 200 exemples diversifiés est souvent recommandé pour stabiliser les performances.
Quelle est la différence principale entre LoRA et QLoRA ?
LoRA adapte les poids via des matrices de rang faible, réduisant le nombre de paramètres à entraîner. QLoRA ajoute une étape cruciale : la quantification 4-bit des poids pré-entraînés du modèle. Cela permet de charger des modèles très grands (comme LLaMA-65B) dans une mémoire GPU limitée (24 Go) sans sacrifier significativement la précision. QLoRA est donc essentiel si vous voulez affiner de grands modèles sur du matériel grand public ou cloud économique.
Le few-shot fine-tuning est-il meilleur que le prompting (in-context learning) ?
Pour les tâches de domaine spécifique, oui. Une étude de la Mayo Clinic (2024) a montré que le prompting sous-performe les modèles affinés de 12 à 18 % sur des tâches comme le codage médical. Le fine-tuning intègre les connaissances directement dans les poids du modèle, libérant la fenêtre de contexte pour la requête utilisateur et offrant une meilleure cohérence et fiabilité, bien qu'il nécessite un cycle d'entraînement initial.
Quels sont les principaux risques d'échec ?
Les deux causes majeures d'échec sont un mauvais choix de taux d'apprentissage (trop élevé, causant une divergence) et un manque de diversité dans les données d'entraînement. Selon les diagnostics Hugging Face, 63 % des échecs proviennent de configurations d'hyperparamètres inadéquates. Assurez-vous toujours d'utiliser l'early stopping et de valider sur un ensemble de données distinct.
Est-ce compatible avec toutes les architectures de LLM ?
La compatibilité est excellente pour les architectures Transformer modernes (LLaMA, Mistral, Falcon, BERT). Cependant, des problèmes peuvent survenir avec des architectures plus anciennes ou exotiques, notés dans 28 % des cas sur les forums GitHub. Vérifiez toujours que la bibliothèque PEFT utilisée supporte explicitement votre modèle cible avant de commencer l'entraînement.