Vous souvenez-vous de l'époque où taper "banque" dans un moteur de recherche vous renvoyait des résultats sur les établissements financiers et les bancs de parc ? C'était frustrant. Aujourd'hui, si vous cherchez "comment optimiser mes coûts cloud", vous ne voulez pas juste voir des pages contenant ces mots-clés exacts. Vous voulez une réponse qui comprend que "cloud migration cost" et "budgeting for a transition" signifient la même chose. C'est là que les Grands Modèles de Langage (LLM) entrent en jeu. Ils transforment nos outils de recherche de simples moteurs de correspondance de mots en véritables moteurs de compréhension.
Ce changement n'est pas juste une mise à jour technique ; c'est une refonte fondamentale de la façon dont nous accédons à l'information. Les systèmes traditionnels se basaient sur des correspondances littérales. Si votre document disait "achat de serveur" et que vous cherchiez "acquisition de matériel informatique", le système classique était perdu. Un système basé sur les LLM, lui, sait que ces deux phrases partagent la même intention. Comment font-ils cela ? En utilisant des concepts comme les embeddings, le re-ranking et l'expansion de requête. Explorons ensemble comment cette technologie fonctionne réellement, sans jargon inutile, et pourquoi elle change tout pour les développeurs et les entreprises en 2026.
Pourquoi la recherche par mots-clés est devenue obsolète
La recherche traditionnelle, souvent appelée recherche lexicale, fonctionne comme une bibliothèque très stricte. Elle cherche des caractères identiques. Le problème ? Le langage humain est désordonné. Nous utilisons des synonymes, nous faisons des fautes, et nous exprimons la même idée de mille façons différentes. Si vous demandez "voiture rapide", vous obtenez des résultats différents de "véhicule performant", même si l'intention est identique. Les Modèles de Langage Grands résolvent ce problème grâce à leur capacité à comprendre le contexte. Ils ne regardent pas seulement les mots isolés, mais la relation entre eux. Par exemple, le mot "Java" signifie quelque chose de très différent selon qu'il apparaît dans une phrase sur le café ou sur la programmation. Un modèle moderne utilise des milliards de paramètres pour saisir cette nuance. Il crée une représentation mathématique du texte, appelée vecteur, où chaque concept a une position précise dans un espace multidimensionnel. Plus deux idées sont proches dans le sens, plus leurs vecteurs sont proches géométriquement. C'est la base de la recherche sémantique.
Le cœur du système : Les Embeddings générés par les LLM
Tout commence par les embeddings. Imaginez que chaque mot ou phrase est converti en une longue liste de nombres. Ces nombres capturent le sens. Avant l'arrivée des LLM, nous avions des modèles plus simples comme Word2Vec ou GloVe. Ils étaient utiles, mais limités. Ils ne comprenaient pas bien le contexte dynamique d'une phrase entière. Aujourd'hui, des architectures comme MPNet ou les variantes de BERT génèrent des embeddings beaucoup plus riches. Ils sont entraînés sur des corpus massifs de texte internet. Ce processus d'apprentissage, souvent basé sur le masquage de tokens (cacher des mots au hasard et demander au modèle de les deviner), force le réseau à comprendre la grammaire, la sémantique et même certaines connaissances du monde réel. La différence est tangible : un embedding généré par un LLM récent reconnaîtra que "apple" dans "apple pie" est lié à la nourriture, tandis que dans "Apple iPhone", il est lié à la technologie. Cette précision réduit drastiquement les faux positifs dans vos résultats de recherche.
Les trois étapes clés pour une recherche intelligente
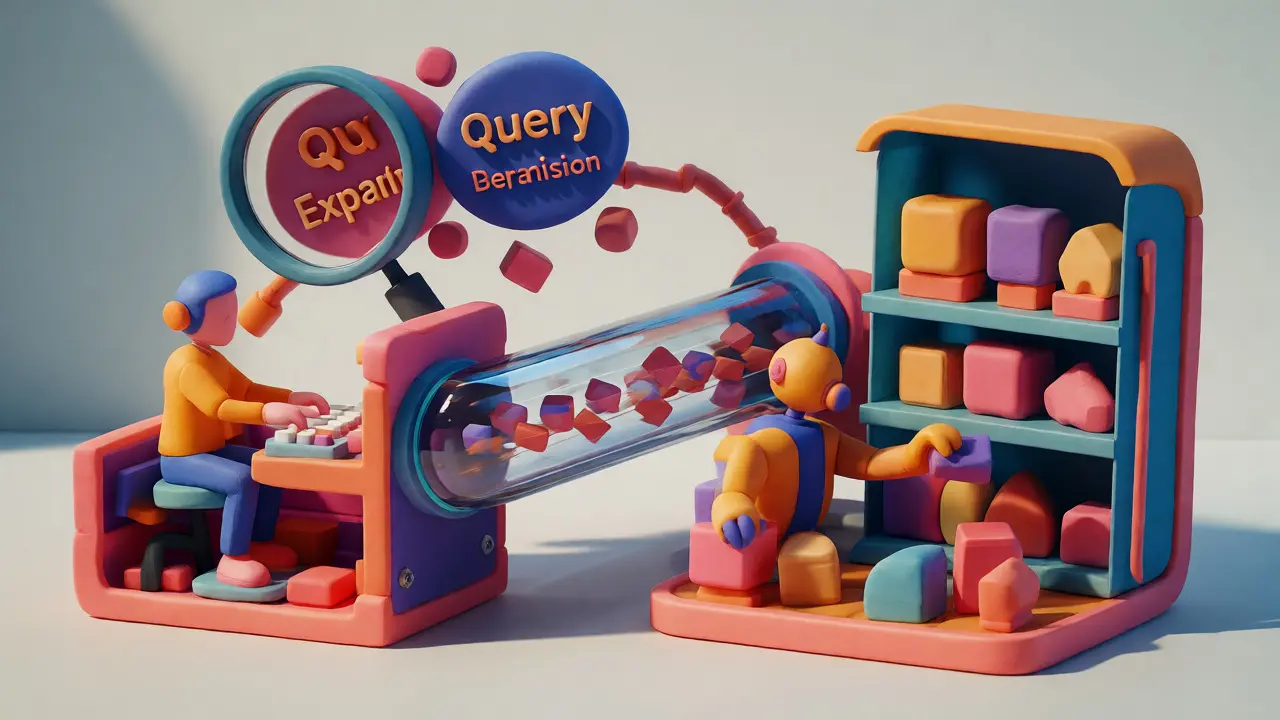
Mettre en place un système de recherche augmenté par les LLM ne consiste pas simplement à remplacer un vieux moteur par un nouveau. C'est un pipeline en trois étapes qui équilibre vitesse et précision. Voici comment cela fonctionne concrètement :
- L'Expansion de Requête (Query Expansion) : Quand un utilisateur tape une question courte, le LLM peut anticiper ses besoins. Si vous cherchez "Oracle Cloud", le système peut automatiquement ajouter des termes connexes comme "comparaison AWS vs OCI" ou "migration de base de données vers OCI". Cela améliore le rappel (recall), c'est-à-dire la capacité à trouver tous les documents pertinents, même ceux qui n'utilisent pas exactement vos mots.
- La Récupération Initiale (Retrieval) : Une fois la requête enrichie, le système effectue une recherche vectorielle rapide. Il compare les vecteurs de votre question avec ceux de millions de documents stockés. Grâce aux index vectoriels modernes, cette étape est extrêmement rapide, gérant des bases de données de plusieurs téraoctets en quelques millisecondes.
- Le Re-ranking (Reclassement) : C'est ici que la magie opère pour la précision. La première étape donne une liste brute de candidats. Le LLM intervient alors pour analyser chaque résultat individuellement. Il lit le document complet et juge sa pertinence réelle par rapport à la question. Un document qui mentionne "migration cloud" une seule fois sera déclassé face à un guide détaillé sur les stratégies de migration. Cette étape corrige les erreurs de la recherche vectorielle pure.
| Critère | Recherche Lexicale (Traditionnelle) | Recherche Sémantique avec LLM |
|---|---|---|
| Compréhension du contexte | Faible (mots isolés) | Élevée (relations entre mots) |
| Gestion des synonymes | Nulle | Native |
| Vitesse de traitement | Très élevée | Élevée (avec optimisation vectorielle) |
| Coût d'infrastructure | Faible | Plus élevé (calcul GPU/CPU intensif) |
| Qualité des réponses | Souvent superficielle | Profonde et synthétique |
Applications concrètes : Au-delà de Google
Si vous pensez que cela ne concerne que les géants de la tech, détrompez-vous. Cette technologie est accessible via des API et des frameworks open source comme LangChain ou Haystack. Prenons l'exemple du commerce électronique. Sur Amazon ou Shopify, la recherche sémantique permet à un client cherchant "cadeau pour gamer" de trouver une manette ergonomique, même si le titre du produit ne contient pas le mot "gamer". Le modèle comprend le lien conceptuel entre "ergonomie", "confort long terme" et "jeux vidéo". Dans les entreprises, les bases de connaissances internes souffrent souvent du même mal que les vieux moteurs de recherche. Les employés perdent du temps à chercher des procédures RH ou des notes techniques. Intégrer un LLM permet de créer des assistants qui répondent directement à la question en citant les sources pertinentes. Par exemple, au lieu de lister dix PDFs sur "congés maladie", le système synthétise la politique actuelle en une phrase claire, tirée du document officiel le plus récent.
Défis et bonnes pratiques pour 2026
Malgré ses avantages, intégrer les LLM dans la recherche pose des défis réels. Le premier est le coût. Calculer des embeddings pour des millions de documents et effectuer du re-ranking demande de la puissance de calcul. Heureusement, des méthodes d'indexation en mémoire et des modèles distillés (des versions plus petites et rapides des grands modèles) réduisent cette facture. Un autre piège courant est l'illusion de la perfection. Les LLM peuvent parfois "halluciner" ou donner trop de poids à des détails mineurs. Pour éviter cela, il est crucial de mettre en place une boucle de feedback. Analysez les clics des utilisateurs. Si ils cliquent souvent sur le troisième résultat plutôt que le premier, votre modèle de re-ranking doit être ajusté. De plus, la fraîcheur des données est critique. Un modèle entraîné sur des données de 2023 pourrait ignorer une nouvelle réglementation entrée en vigueur en 2025. Assurez-vous que votre pipeline de mise à jour des embeddings est automatisé et fréquent.
Enfin, n'oubliez pas la confidentialité. Envoyer des données sensibles à une API externe pour obtenir des embeddings peut poser problème. Pour les secteurs réglementés comme la santé ou la finance, envisagez d'héberger des modèles open source localement. Des solutions comme Llama 3 ou Mistral permettent aujourd'hui d'obtenir des performances proches des leaders commerciaux tout en gardant le contrôle total sur vos données.
Quelle est la différence principale entre la recherche sémantique et la recherche par mots-clés ?
La recherche par mots-clés correspond littéralement aux termes tapés, tandis que la recherche sémantique comprend l'intention derrière la requête. Elle utilise des embeddings pour identifier des documents liés par le sens, même s'ils ne partagent aucun mot commun avec la question initiale.
Les LLM rendent-ils la recherche vectorielle obsolète ?
Non, ils la complètent. La recherche vectorielle reste essentielle pour la rapidité de récupération initiale. Les LLM interviennent ensuite pour affiner les résultats via le re-ranking et l'expansion de requête, créant un système hybride plus efficace que l'un ou l'autre seul.
Comment améliorer la précision de ma recherche existante avec un LLM ?
Commencez par implémenter une étape de re-ranking. Utilisez un modèle léger pour réévaluer les top 100 résultats issus de votre moteur actuel. Cette approche offre un gain immédiat de pertinence sans nécessiter une refonte complète de votre infrastructure de stockage.
Qu'est-ce que l'expansion de requête et pourquoi est-elle utile ?
L'expansion de requête est le processus par lequel le LLM génère des termes associés à la question originale. Elle aide à récupérer des documents pertinents qui utilisent un vocabulaire différent, améliorant ainsi le taux de rappel (recall) du système de recherche.
Est-il coûteux d'entraîner ses propres embeddings ?
Cela dépend de la taille de votre dataset. Pour des projets moyens, utiliser des modèles pré-entraînés via API est souvent plus économique que l'entraînement local. Cependant, pour des volumes massifs ou des besoins de confidentialité, l'hébergement local de modèles open source devient rentable à long terme.